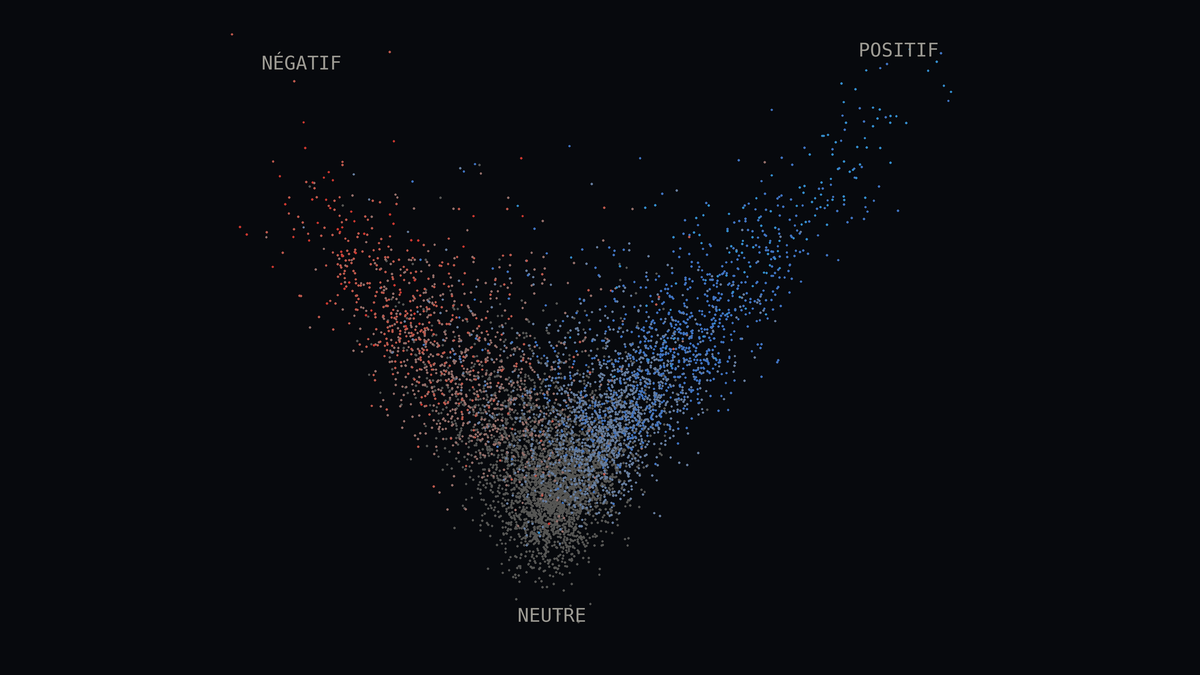
Fin septembre, au TeknSEO à Toulouse, j’ai passé 1h20 à expliquer qu’un petit modèle entraîné sur vos propres données fait souvent mieux, plus vite et moins cher qu’un gros modèle à qui on pose la question. Début novembre, je lis le billet de Dejan sur son classifieur de sentiment à sept niveaux. Trois jours plus tard, un dataset ouvert et deux modèles en six langues étaient en ligne. Et vous pouvez contribuer : je cherche à annoter à la main un jeu de référence (un dataset « gold »), et votre aide sera très appréciée (c’est par ici). Je vous montre ici l’envers du décor.
Lire la suite Sept nuances de sentiment, six langues et trois jours de bidouille