Fin septembre, au TeknSEO à Toulouse, j’ai passé 1h20 à expliquer qu’un petit modèle entraîné sur vos propres données fait souvent mieux, plus vite et moins cher qu’un gros modèle à qui on pose la question. Début novembre, je lis le billet de Dejan sur son classifieur de sentiment à sept niveaux. Trois jours plus tard, un dataset ouvert et deux modèles en six langues étaient en ligne. Et vous pouvez contribuer : je cherche à annoter à la main un jeu de référence (un dataset « gold »), et votre aide sera très appréciée (c’est par ici). Je vous montre ici l’envers du décor.
Le point de départ : un atelier sur les petits modèles
L’atelier s’appelait « Google classifie tout, même vous. Faites pareil. » L’idée de départ : Google range chaque requête, chaque page, chaque site dans des cases, et un SEO a tout intérêt à savoir en faire autant sur ses propres données. Entre-temps, Jev était sorti, le classifieur zero-shot qui répond avec des probabilités, et j’ai cru un moment devoir refaire tout l’atelier. En creusant, l’argument a résisté, et même mieux qu’avant : le moteur est à la portée de tout le monde, donc l’avantage vient des règles qu’on lui donne et du dataset sur lequel on le valide.
Trois leçons de l’atelier ont servi ici presque telles quelles :
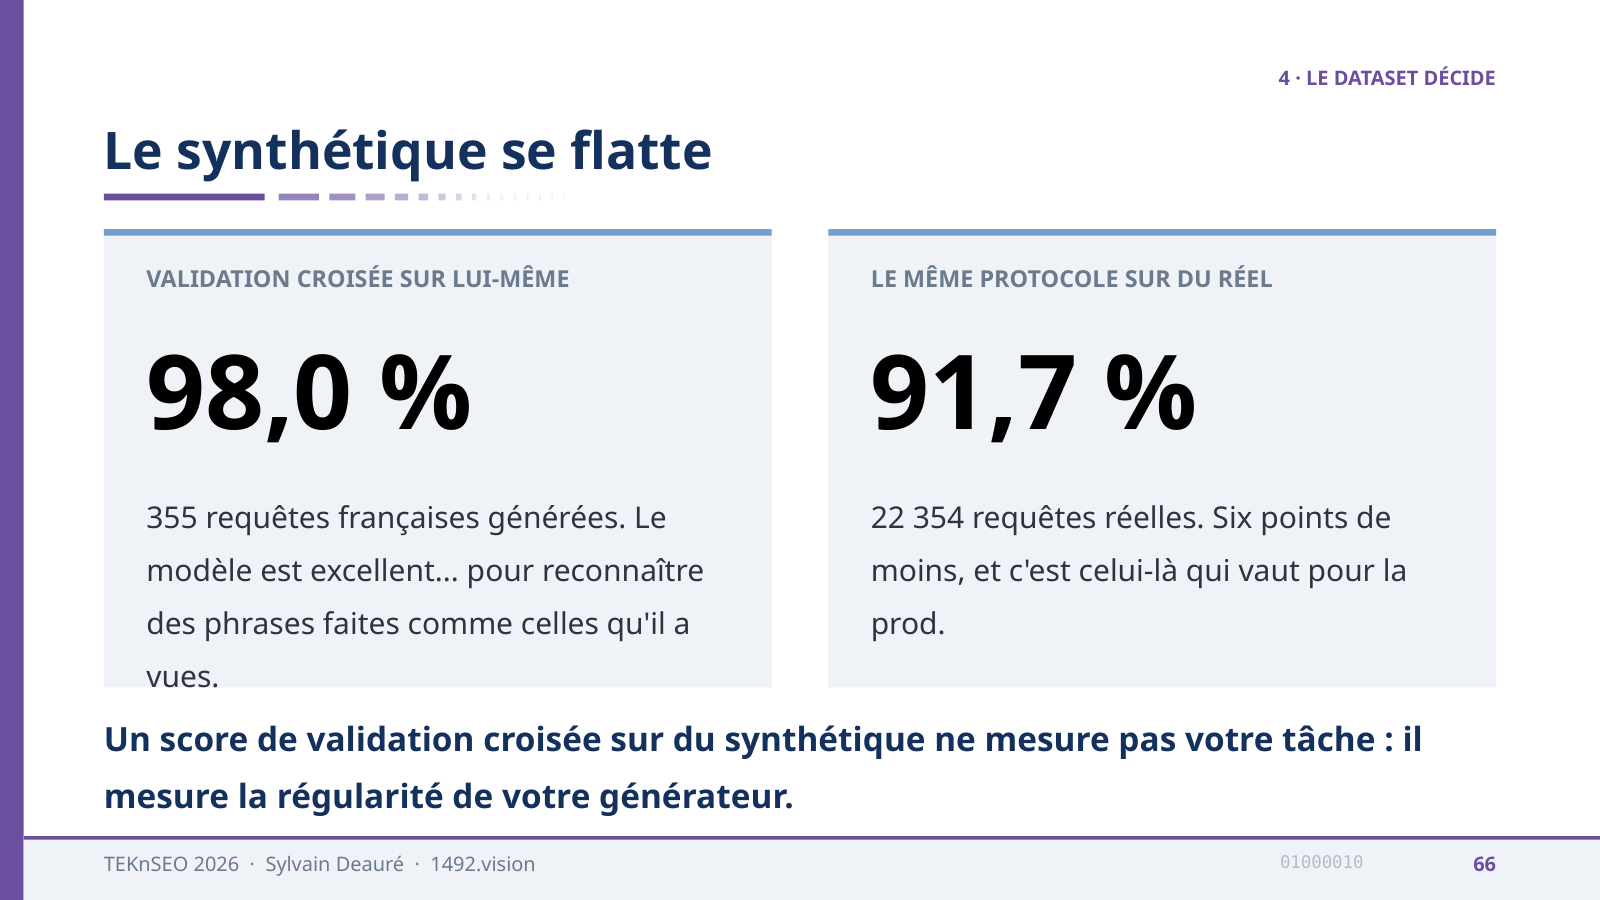
- le synthétique se flatte. Sur des requêtes françaises générées par un LLM, mon classifieur affichait 98 % en validation croisée. Sur 22 354 requêtes réelles, 91,7 %. Le score sur du texte généré mesure surtout la régularité du générateur ;
- la recette silver : du texte réel, étiqueté en volume par un LLM, puis seulement du synthétique pour boucher les trous ;
- un encodeur, des petites têtes. Un SVM sur des embeddings atteignait 91,7 % en 31 secondes de CPU. Pour N tâches, on déploie un encodeur et N têtes de quelques Ko, au lieu de N modèles complets.
Gros flottement dans la salle, quand je montre les tests que certains ont fièrement exhibés en ligne, par exemple en triant leurs mails ou leurs tickets support. Oui : de la data utilisateur, avec des infos sensibles et personnelles, envoyées sans se poser de question à un serveur aux US ou en Chine. Tout va bien.
Le billet de Dejan
Il y a quelques jours, Dejan (Dan Petrovic) a publié un classifieur de sentiment à sept niveaux, de -3 à +3. Ça a fait tilt : classer du texte avec des petits modèles est mon terrain de jeu du moment.
Dans son billet, j’ai tout de suite adopté trois idées :
- l’échelle à sept niveaux. Le trio positif / neutre / négatif des datasets classiques écrase tout ce qui intéresse un SEO : une réserve polie et une colère froide finissent dans la même case ;
- l’étiquetage en contexte : chaque phrase est notée par un LLM qui a le texte entier sous les yeux. « Ils ont encore frappé » se lit très différemment selon qu’on parle d’un groupe de rock ou d’un spammeur ;
- les 26 formats de texte du web : fiche produit, avis, fil de forum, communiqué, FAQ… Le sentiment d’une page produit et celui d’un fil de forum ne se mesurent pas avec la même règle.
Son modèle est entraîné sur des textes synthétiques en anglais. J’ai voulu voir ce que donne la même idée nourrie de web réel, en six langues, avec la recette de l’atelier.
Du web réel, et un peu de synthétique
J’ai tiré des passages au hasard dans FineWeb (anglais) et FineWeb-2 (français, espagnol, allemand, italien, portugais), puis fait noter chaque phrase par Claude Sonnet, avec le passage complet en vue et la grille à sept niveaux. Au bout : 452 410 phrases issues de 27 409 passages, dont 86 % de vrai texte web.
Piège au passage : bien qu’il soit censé être plus “propre” que CommonCrawl, FineWeb contient encore des cochonneries sans nom. Pensez donc toujours à filtrer si vous basez des choses publiques dessus, ça peut faire peur !
Le web réel a un autre défaut : il est tiède. Environ la moitié des phrases sont neutres, et le -3 pèse moins de 1 % du lot. Pour trouver des phrases très négatives, j’ai d’abord essayé de les faire écrire. Raté, en partie : quand je demande à Claude un texte « très négatif » puis que je le fais noter phrase par phrase, seules 11 % des phrases reviennent en -3, et la moitié en -2. Le même modèle qui écrit « très négatif » relit son texte comme simplement négatif :).
La présélection apprise a mieux marché. Une petite régression logistique
entraînée sur mes premières étiquettes prédit « ce passage contient un -3 ».
Parmi les passages qu’elle choisit, 21 % des phrases sont notées -3, contre
moins de 1 % au hasard. Le synthétique est resté, marqué dans une colonne
source, pour les formats que le web fournit mal (mails clients, scripts
publicitaires, réponses de support). Pour l’entraînement du modèle, il n’a
rien apporté sur le web naturel, et je l’ai laissé de côté.
Un encodeur figé et une tête de 119 Ko
J’ai testé l’option retenue par Dan, celle qui consiste à fine-tuner un petit LLM complet. À données égales, il ne faisait pas mieux qu’un encodeur figé avec une régression logistique par-dessus, et il variait beaucoup plus d’une graine aléatoire à l’autre. J’ai donc gardé la solution de l’atelier : EmbeddingGemma-300m, qu’on ne touche pas, et une tête linéaire de sept classes. La tête tient dans un fichier JSON de 119 Ko : 7 × 768 poids, 7 biais et un vecteur moyen.
Une analogie que j’aime bien : l’encodeur est un bibliothécaire qui range chaque phrase sur une étagère selon ce qu’elle raconte, la tête est une règle qu’on pose sur l’étagère pour lire le sentiment. On peut poser d’autres règles sur les mêmes étagères (thème, intention, format) sans réembaucher de bibliothécaire.
Sur 9 jeux de test annotés par des humains, en six langues, la tête atteint 0,673 de macro-F1 en trois classes. Le LLM qui a étiqueté les données fait 0,726 sur les mêmes jeux : un modèle qui apprend ses étiquettes a peu de chances de le dépasser, et la tête s’en approche à 5 points.
Autre réglage qui compte : le centrage. On soustrait aux vecteurs leur moyenne avant d’appliquer la tête. Centrer sur la moyenne de votre propre corpus donne 0,673, centrer sur la moyenne de référence livrée avec la tête donne 0,641. Trois points pour une soustraction, ce n’est pas cher payé !
Le préfixe qui manque
EmbeddingGemma attend un préfixe devant le texte selon la tâche, ici
task: classification | query: . C’était déjà une slide de l’atelier :
tous les préfixes ne se valent pas. Sauf que plusieurs outils qui
produisent des embeddings ne laissent pas ajouter de préfixe libre. Une
tête entraînée avec le préfixe et nourrie de vecteurs sans préfixe perd
3 à 10 points selon le jeu de test.
D’où une deuxième tête, entraînée sur des vecteurs sans préfixe : elle récupère l’essentiel (0,662). Dans le navigateur, avec l’encodeur quantifié en ONNX (309 Mo en q8, 197 Mo en q4), la tête perd 0,3 et 0,8 point, et les phrases ne quittent pas la machine.
Lire la phrase avec sa page
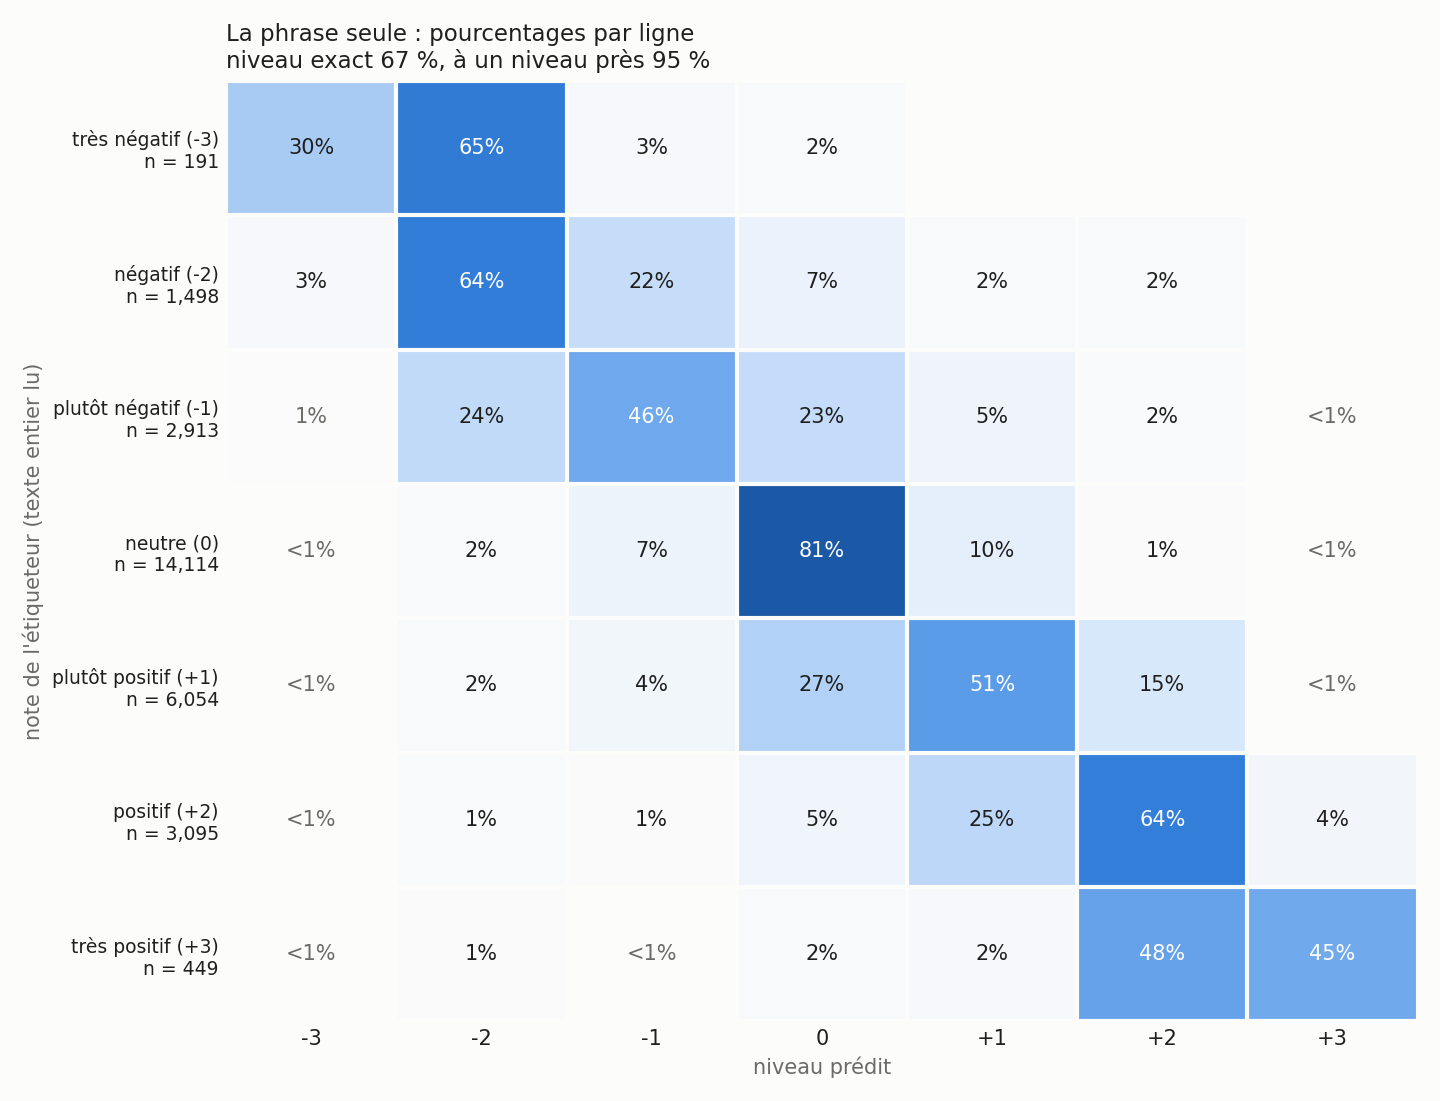
L’étiqueteur lit chaque phrase avec le passage entier. Le modèle, lui, ne voit que la phrase. Une partie des étiquettes dépend donc d’une information que le modèle n’a jamais : qui sont « ils », ou la mise en place ironique deux phrases plus haut.
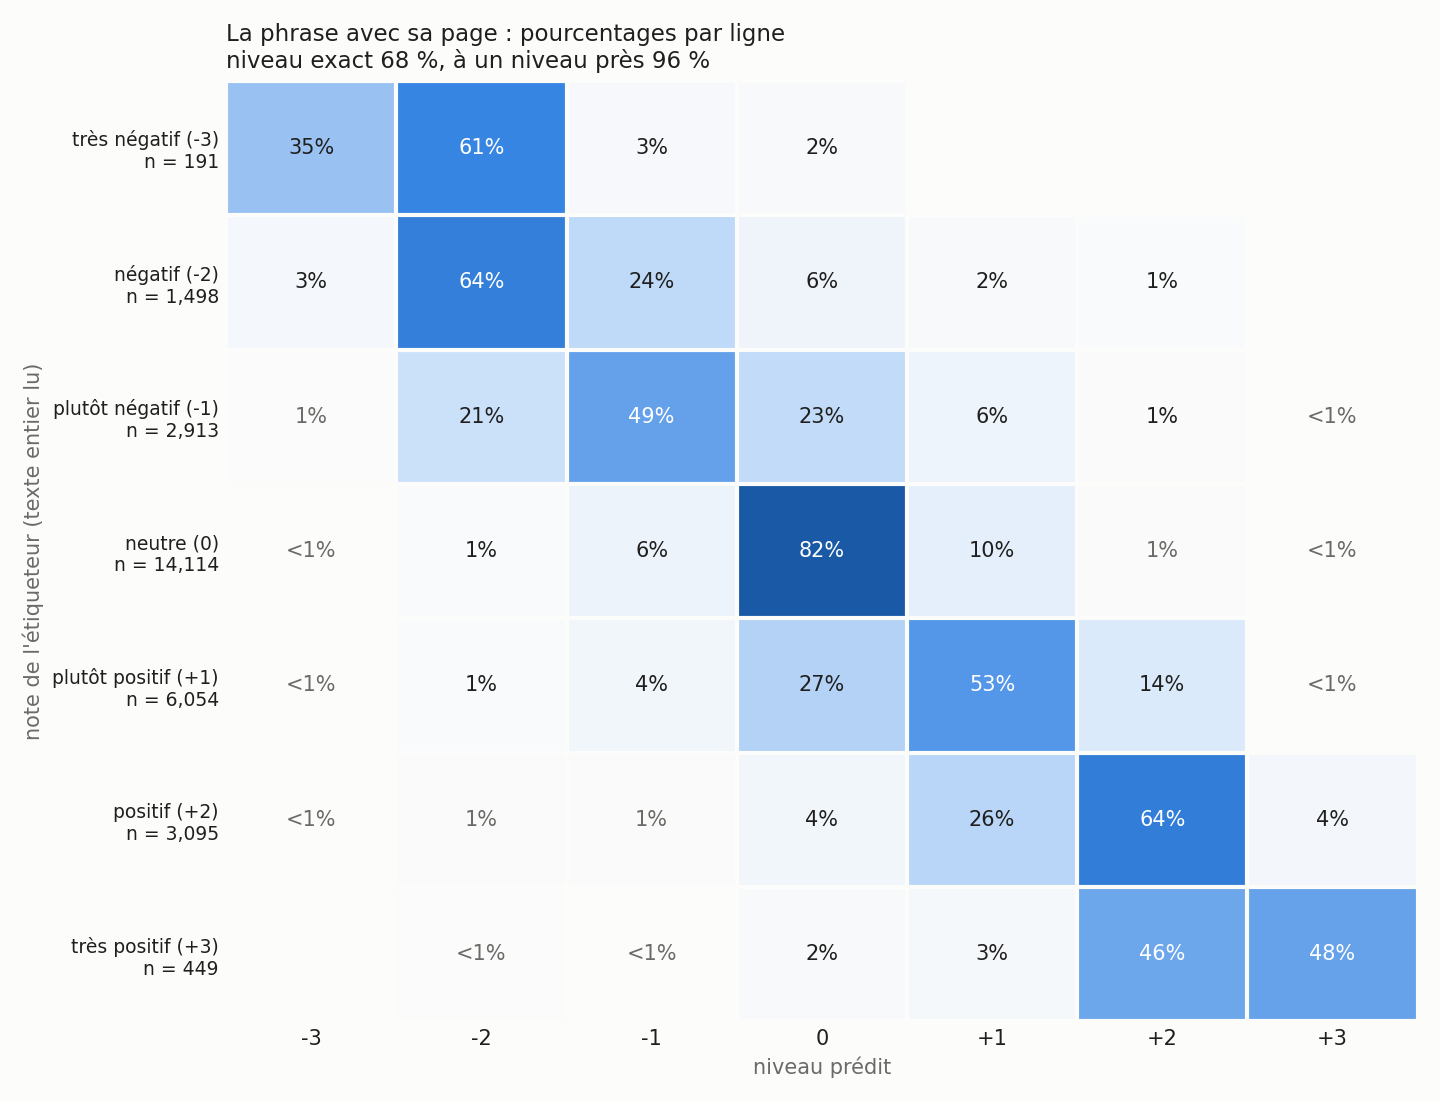
L’essai le plus simple : donner à la tête deux vecteurs, celui de la phrase et celui du passage complet, mis bout à bout. Sur le web naturel, en sept niveaux, le macro-F1 passe de 0,539 à 0,565. Pour vérifier que le gain vient du contexte et pas des dimensions en plus, j’ai entraîné la même tête avec le passage d’une autre page, tirée au hasard dans la même langue : 0,534, aucun gain. Le contexte fait le travail, surtout sur les niveaux extrêmes. C’est devenu un modèle à part, expérimental, lui aussi disponible librement.
La galaxie en V
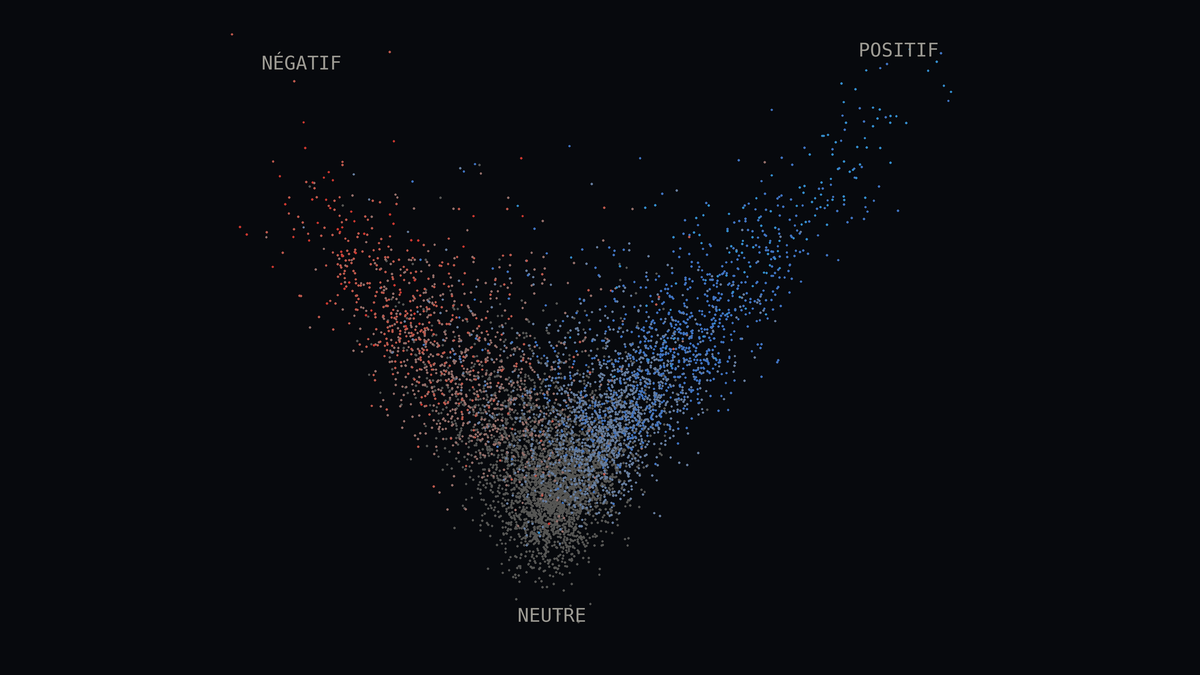
Pour la page du projet, je voulais montrer à quoi ressemble le sentiment dans l’espace de l’encodeur. J’ai projeté 20 000 phrases que le modèle n’a jamais vues sur les trois axes qui séparent le mieux les sept niveaux (une analyse discriminante linéaire). Le résultat a une forme de V : le neutre à la pointe, un bras pour le positif, un bras pour le négatif, et l’intensité qui grandit en remontant les bras. Le premier axe porte la polarité (corrélation de 0,77 avec la note), le second l’intensité.
C’est l’image en tête de cet article. La galaxie en mode interactif, 2D ou 3D, pour tourner autour (légendes en anglais).
Le truc qui m’a soufflé en regardant ce visuel, sorti des specs ? Pour moi, il fonctionne comme une illusion d’optique. En mode 2D, alors que rien ne bouge vraiment, je vois l’ensemble des points “tourner” si je regarde dans le vide sans fixer le regard. Ça vous le fait aussi ?
Ce qui reste dur : l’ironie et les phrases mitigées
J’ai fait taguer les 10 708 phrases des jeux de test par phénomène linguistique (ironie, négation, contraste, comparaison…) pour voir où les erreurs se concentrent. L’ironie et les phrases mitigées, un bout positif et un bout négatif, multiplient par 2,5 environ le risque d’inverser la polarité. C’est vrai pour tous les systèmes testés, l’étiqueteur compris. Ma tête a une faiblesse en plus : négation, contraste (« mais », « cependant ») et comparaisons augmentent ses inversions de 1,4 à 1,9 fois. Un encodeur figé saisit probablement moins bien la portée des petits mots logiques ; je ne l’ai pas encore testé. L’objectif ici était un petit modèle, rapide et qui tourne dans un navigateur plutôt que la qualité optimale.
L’addition
Environ 112 $ d’API pour l’ensemble du chantier : la classification des formats, le synthétique, l’étiquetage, deux tours de collecte. Les encodages et les entraînements ont tourné sur mes GPU. Le synthétique coûte environ un demi-centime par passage, génération et étiquetage compris. Le web réel coûte moins cher et donne de meilleurs modèles.
En ligne depuis le 4 novembre
- WebSentiment ML-7, le dataset : 452 410 phrases, 6 langues, licence ODC-By, DOI 10.5281/zenodo.23964284.
- websentiment-egemma-ml-7, le modèle principal, avec et sans préfixe, en Python ou dans le navigateur, licence CC BY 4.0, DOI 10.5281/zenodo.23981493.
- websentiment-egemma-ml-7-ctx, le modèle avec contexte, expérimental, DOI 10.5281/zenodo.23982301.
- La démo : on colle un texte, chaque phrase est notée et surlignée en vert ou en rouge, seule ou dans le contexte du texte entier : https://huggingface.co/spaces/SDeaure/websentiment-demo
Tout est décrit, avec les licences et la façon de créditer, sur https://sylvain-deaure.fr/en/websentiment/. L’échelle, l’étiquetage en contexte et les formats viennent du travail de Dejan, et je l’en remercie : c’est le genre de billet qui donne envie d’ouvrir un terminal.
Un coup de main pour le gold humain
Aucune phrase du dataset n’a été notée par un humain. L’accord de l’étiqueteur avec des annotateurs humains est mesuré sur des jeux de recherche existants, mais ces jeux sont surtout faits de tweets et de critiques de films. Il manque un jeu de référence humain sur du vrai texte web, dans les six langues.
Si vous lisez l’une des six langues et que vous avez un moment, vous pouvez noter quelques phrases ici : https://huggingface.co/spaces/SDeaure/websentiment-gold. On se connecte avec son compte Hugging Face, chaque phrase s’affiche avec son passage, on choisit un niveau de -3 à +3, et on passe à la suivante. Ceux qui le souhaitent seront remerciés nommément dans la fiche du jeu final.
Pour aller plus loin
- Le billet de Dejan qui a tout lancé : Sentiment model.
- Le compte rendu de l’atelier TeknSEO par Johan Puisais : JEV et SEO : les limites que Sylvain Deauré rappelle aux SD Days 2026.